Vercelに「DeepSeek V4.1 Flash」高速版 速さと引き換えに料金8倍
Vercelは11月7日、AI Gatewayで「DeepSeek V4.1 Flash」の10月17日版を高速に動かす「Ultrafast」を公開プレビューにした。Fireworksの環境で毎秒1000トークンを超えて出力できる一方、料金は通常版の8倍になる。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
Vercelは11月7日、複数のAIモデルを1つのAPIで呼べる窓口「AI Gateway」で、DeepSeekのモデル「DeepSeek V4.1 Flash」の10月17日版を高速に動かす「DeepSeek V4.1 Flash 1017 Ultrafast」を使えるようにした。推論はFireworksの高速なサーバーレスの環境が受け持ち、毎秒1000トークンを超える速さで出力できるという。ただし料金は通常版の8倍だ。コーディングエージェントの待ち時間を、お金で縮めるかどうかを選べるようになる。
モデル名を1つ替えるだけで使える
VercelのAI Gatewayの更新履歴によると、提供は公開プレビューの扱いで、順番待ちの列も、1回の利用時間の上限も無い。文脈の長さは100万トークンで、大きなコードベースや長い入力を一度に渡せる。Vercelは、対話しながらのコーディングや推論、エージェントの作業のように、出力を受け取ってすぐ次の手順へ進みたい用途に向くと説明している。
使い方は、モデル名に 「deepseek/deepseek-v4.1-flash-1017-ultrafast」 を指定するだけだ。VercelのAI SDKのほか、OpenAI互換のChat Completionsの形でも呼べる。その場合は接続先を 「https://ai-gateway.vercel.sh/v1」 にし、AI GatewayのAPIキーを渡す。Claude Code・Codex・Cursorで使う時は、最新のVercel CLIで 「npx vercel ai-gateway setup」 を実行し、エージェントの側でこのモデルを選ぶ手順になっている。
AI Gatewayのモデルのページは、文字と画像の入力、推論の深さの設定、ツールの呼び出し、構造化された出力、プロンプトの前半を使い回す自動のキャッシュに対応すると書く。最大の出力も文脈と同じ104万8576トークンだ。
速さの代わりに料金は8倍
同じモデルのページでは、料金は入力100万トークンあたり2.40ドル、出力100万トークンあたり9.60ドルだ。一方、Fireworksのモデルのページに載る通常のサーバーレス版の料金は、入力0.30ドル、出力1.20ドルにとどまる。つまり高速版は、入力も出力もちょうど8倍の値付けになる。
たとえば出力を100万トークン受け取ると、通常版は1.20ドル、高速版は9.60ドルかかる。エージェントが長いコードを何度も書き直す作業では、出力の量がそのまま費用に跳ね返る。速さを買う価値があるかは、人が画面の前で待つ作業か、夜間に回して結果だけ見る作業かで変わってくる。
Vercelは、AI Gatewayの料金は各社の料金をそのまま反映し、上乗せをしないと説明している。推論に手数料は取らず、自分のキーを持ち込む使い方でも同じだという。8倍の差は窓口の手数料ではなく、高速な環境そのものの値段ということになる。
中身は10月17日に更新した版
元のモデルは、DeepSeekが10月17日に出した更新版だ。DeepSeekのAPIの更新履歴によると、V4.1 Flashはこの日「DeepSeek-V4.1-Flash-1017」に入れ替わり、公式のWebとアプリのモデルも新しい版になった。DeepSeek自身のAPIでは、呼び方も料金も変わっていない。
同じ更新履歴は、前の版より成績が上がったと書く。たとえばClaude Codeの枠組みで測った「Terminal-Bench 4.0」は42.3で、9月10日の公開時の31.2から上がった。課題を解き終えるまでの時間と出力の長さも縮め、より安く速く作業を終えられるようにしたという。Fireworksのページは、このモデルを7550億パラメーターの混合専門家(MoE、入力ごとに一部の専門家だけを動かす作り)としている。
エージェントの待ち時間を縮める選択肢
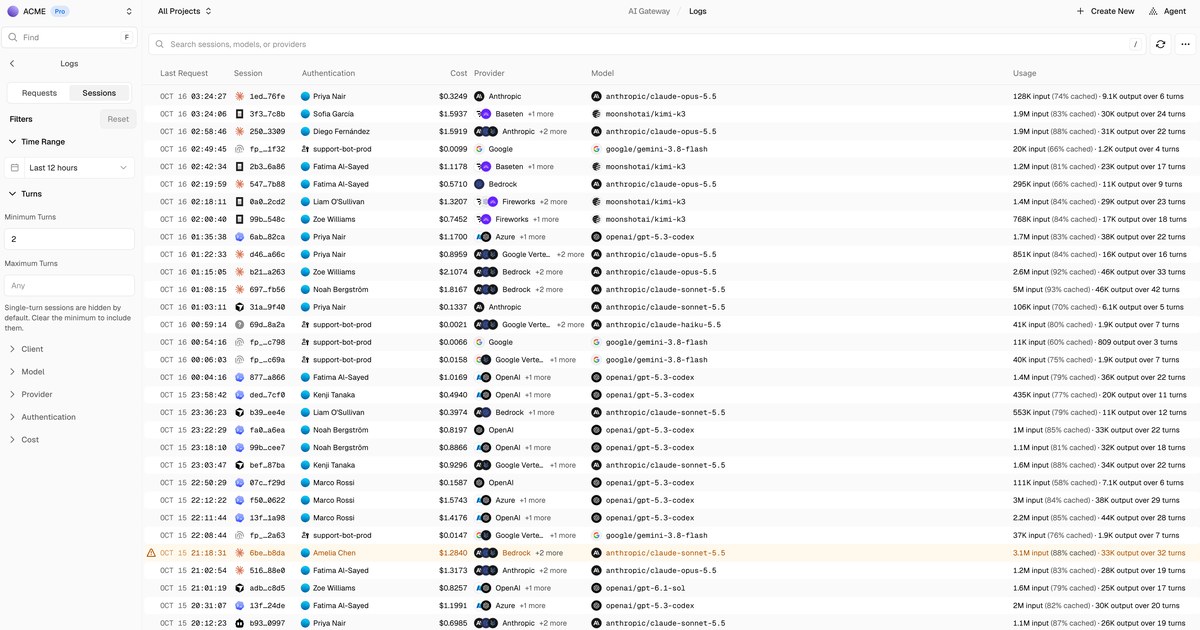
AI Gatewayには、利用量と費用の記録、失敗した時の再試行、別の提供元への切り替え、APIキーごとの予算といった機能がそろう。8倍の料金のモデルでも、キーに予算を付ければ使いすぎを抑えられる。高速版は、DeepSeekの新しい版を、速さを優先して選べる道をVercelの窓口に1つ足した。待ち時間を縮めるか費用を抑えるかを、モデル名1つで切り替えられるようになったわけだ。
編集部の見方
コーディングエージェントで一番もどかしいのは、出力を待つ時間だ。毎秒1000トークンを超える速さなら、数千トークンの出力も数秒で返ってくる計算になり、対話しながら直す作業の手触りが変わる。ただし8倍の料金は軽くない。まずは人が待っている対話の作業にだけ高速版を当て、夜間のまとめ処理は通常版のまま回すのが現実的だ。速さの数字はVercelの説明によるもので、手元の作業で本当に速くなるかは、APIキーに予算を付けたうえで試してから決めたい。
出典
に確認(日本時間)
- AI Gatewayの更新履歴(vercel.com)
- AI Gatewayのモデルのページ(vercel.com)
- Fireworksのモデルのページ(fireworks.ai)
- APIの更新履歴(api-docs.deepseek.com)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます