Vercelの集計で「判断モデル」がリクエストの26%に 10月の本番の通信
分類や判定を安い専用のモデルに任せる使い方が、本番の通信でどこまで広がったかをVercelの集計の数字で示す。LLMを組み込んだアプリの費用の見直しに使える。
米Vercelが公開したAI Gatewayの本番の通信の集計11月版によると、10月に同ゲートウェイを通ったリクエストの26.1%が、分類や採点の答えを返す「判断モデル」向けだった。費用に占める割合は0.53%で、数字は同社のゲートウェイを通った通信だけを数えている。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
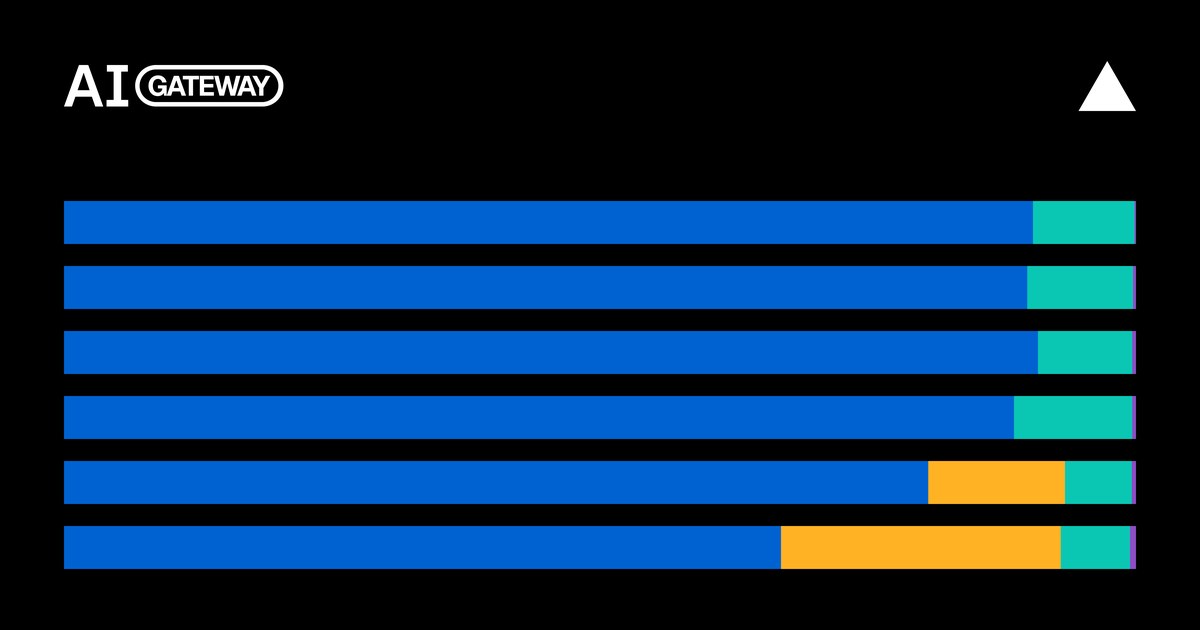
米Vercelは11月9日、自社のAI Gatewayを通った本番の通信を集計した「AI Gateway Production Index」の11月版を公開した。ベンダー自身の集計で、10月にAI Gatewayを通ったリクエストの26.1%は、文章を生成せずに分類・採点・選択の答えを返す「判断モデル」向けだった。8月は0%で、費用に占める割合は0.53%にとどまる。
判断モデルは2か月で26%に
VercelのAI Gateway Production Index 11月版は、判断モデルを言語モデルや埋め込みとは別の種類として集計した。同社の説明では、判断モデルは文章の代わりに分類や採点や選択の結果を返す。1リクエストあたりの費用は言語モデルの約70分の1だという。判断モデルがAI Gatewayに加わったのは9月半ばで、11月版の時点では8社の15モデルがある。
AI Gatewayのリクエストに占める判断モデルの割合は、8月の0.0%から9月に12.8%、10月に26.1%へ伸びた。同じ期間に言語モデルは88.6%から66.9%に下がり、埋め込みと再ランキングは10月に6.5%だった。判断モデルへのリクエストのほぼすべては、TypeSafe AIの「Jev」に向かったという。
前月の10月版のレポートも、Jevを判断モデルと書いている。Jevは9月17日に公開され、最初の2週間で有料チームの35%に広がった。月の半ばからの公開ながら、9月で最も多くのリクエストを受けたモデルでもある。費用では9月の0.15%にすぎなかった。
判断モデルの使い方は、AI Gatewayの判断モデルの開発者向け文書にある。答えは選択肢・スコア・真偽の確率で返る。分類・振り分け・基準に沿った採点・自動の検証に向くという。文書の例では、「カードが二重に請求された」という問い合わせを請求・配送・技術の3つから振り分け、請求の確率を1と返している。
有料チームの3割近くが利用
11月版によると、10月にAI Gatewayを使った有料チームの3割近くが判断モデルを使った。約11%は、文章を生成するモデルに1件もリクエストを送らずに、判断モデルを使っていた。チームの規模が大きいほど使う割合は高い。月のトークンが1000万未満のチームでは5つに1つ強が使い、1億から10億のチームでは半数近く、100億を超えるチームでは10のうち7つが使った。
費用の面では、判断モデルの比重は小さい。11月版は、Jevに1ドルを使うごとに、チームは米Anthropicのモデルに64ドルを使ったと書く。10月に有料チームの利用の割合が高かったモデルは、Jevが28%で首位、続いてSonnet 5.5が26%、Haiku 5.5が22%、Haiku 4.5が20%、GPT-6 Lunaが19%、Opus 5.5が18%だった。Opus 5.5は公開後初めての丸1か月で全体の費用の約7分の1を占め、費用では首位だった。
会社ごとの数字もある。10月に新しく有料になったチームのうち、最初の月に言語モデルのリクエストを最も多く送った先がAnthropicだったチームは42.7%で、米OpenAIの24.0%、米Googleの16.5%を上回った。AI Gatewayの費用に占める割合では、Anthropicが2025年12月の69.2%から2026年10月の32.2%に下がり、OpenAIは同じ期間に8.6%から14.5%に上がった。前月の10月版は、9月のAnthropicの割合を43.9%としていた。10月の言語モデルのリクエストの52.7%は、公開から60日以内のモデルに向かった。
数えたのはVercel経由の通信だけ
11月版の説明によると、数字は2026年10月までにAI Gatewayを通った通信を匿名化して集計した。費用は公開の定価による見積もりで、実際の請求とは違い得る。有料チームはその月に有料のリクエストを1件以上送ったチームで、規模はその月の総トークンで分けた。判断モデルかどうかはAI Gatewayのモデル一覧の分類に従い、モデルの版は別々に数える。過去の月の数字は集計の方法を変えると直ることがあるという。
集計の範囲も限られる。Vercelのリーダーボードの説明は、AI Gatewayの数字はAI市場の全体を表さないと書き、1つの会社が複数のチームを持てるとしている。11月版はリクエストの数え方を説明していない。開発者向け文書によると、判断モデルは1回のリクエストで複数の問いに答えられるので、リクエストの件数は問いの数と同じとは限らない。
26%は、リクエストの件数で測った割合でもある。費用で測ると10月の割合は0.53%で、件数で測った割合のおよそ50分の1にとどまる。
分類や判定を安いモデルに分ける
開発者向け文書によると、判断モデルはAI SDKの「decide」の関数か、HTTPの「/v1/decisions」で呼ぶ。AI SDKでは「ai」の7.0.128以降でこの関数を使い、それより前のAI SDK 7では「experimental_evaluate」で呼ぶ。どちらも名前に実験的な機能の印が付いている。Chat CompletionsやAnthropic互換の入り口からは呼べない。
文書の例は、問い合わせの振り分けのほか、ビルドの終了コードから成否を判定する問い、プルリクエストの品質を4段階で採点する問いを並べている。確信度が低い時に別のモデルで答え直す設定もある。その時は2回分の料金がかかる。文書は自動で実行する前に、結果が合意済みの事例で試すよう求めている。測るのは誤った処理の数と人のレビューの手間だ。
つまりアプリの中で「振り分けるだけ」「合否を出すだけ」の処理は、文書の例のように判断モデルに回せる。Vercelの集計では、10月にAI Gatewayを通ったリクエストの4件に1件が判断モデル向けで、そのほぼすべてがJevだった。費用では0.53%にとどまる。
編集部の見方
編集部は、26%という数字を「判断モデルが言語モデルを置き換え始めた」と読むのは早いと見る。数えたのはVercel経由のリクエストの件数で、費用では0.53%、しかもほぼすべてが1つのモデルに集まっている。読者が確かめるとよいのは、自分のアプリの処理のうち、答えが選択肢か点数で済む処理がどれだけあるかだ。そこを判断モデルに回し、誤りの数と費用を測ってから広げるとよい。Jev以外のモデルにも利用が広がれば、この見方は変わる。
出典
に確認(日本時間)
- AI Gateway Production Index 11月版(vercel.com)
- 10月版のレポート(vercel.com)
- 判断モデルの開発者向け文書(vercel.com)
- リーダーボードの説明(vercel.com)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます