GPT-6 Astraに古いポータルを任せる Shieldの事例が示す数字と測り方
GPT-6 AstraにAPIの無い社内のポータルの作業を任せられるかを、OpenAIの顧客事例とShield自身の評価の数字に分け、測り方と限界を添えて示す。IT運用の自動化の範囲を決める時に使える。
米OpenAIは11月13日、IT業者向けのAI基盤Forgeを作るShieldの顧客事例を公表した。APIの無い古いポータルでのブラウザの作業を、GPT-6 Astraのエージェントに渡している。従来のモデルより平均35〜40%速いという数字は担当者の発言で、測り方は書かれていない。Shield自身の評価では、過去に誤った52件のチケットで、GPT-6 Astraの最高の設定でも通過率は61.5%だった。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
米OpenAIは11月13日、顧客事例のページで、IT業者向けのAI基盤Forgeを作るShieldの取り組みを公表した。
ShieldはAPIの無い古いポータルでのブラウザの作業を、GPT-6 Astraのエージェントに渡している。従来のモデルより平均35〜40%速いという数字は担当者の発言で、測り方は書かれていない。
事例の数字とShieldの評価の表
事例によれば、Forgeのエージェントは以前、入れないシステムで止まり、顧客は技術者の手を待っていた。以前の画面操作のモデルは、信頼性も速さも足りなかったという。
今はForgeのAI Engineerがチケットを受け、画面操作のエージェントに作業を割り当てる。エージェントはチケットや機器、ライセンスを管理するポータルを画面の操作で進める。
数字は2つある。1つは、技術責任者のMayank Jain氏が語る、従来の画面操作のモデルより平均35〜40%速いという値だ。もう1つは、ブラウザの作業が提供先のIT業者全体で月に数千回動いているという値である。
事例はほかに、失敗とタイムアウトが減り、AIが関わったチケットで顧客満足が高いと書くが、どれも数字は無い。エージェントへの指示を書く手間が減ったという話も、時間の数字は添えていない。
Shieldは10月30日に、自社のブログでモデルの評価を公表している。過去にエージェントが誤った52件のチケットで、15のモデルの57の設定を比べた。
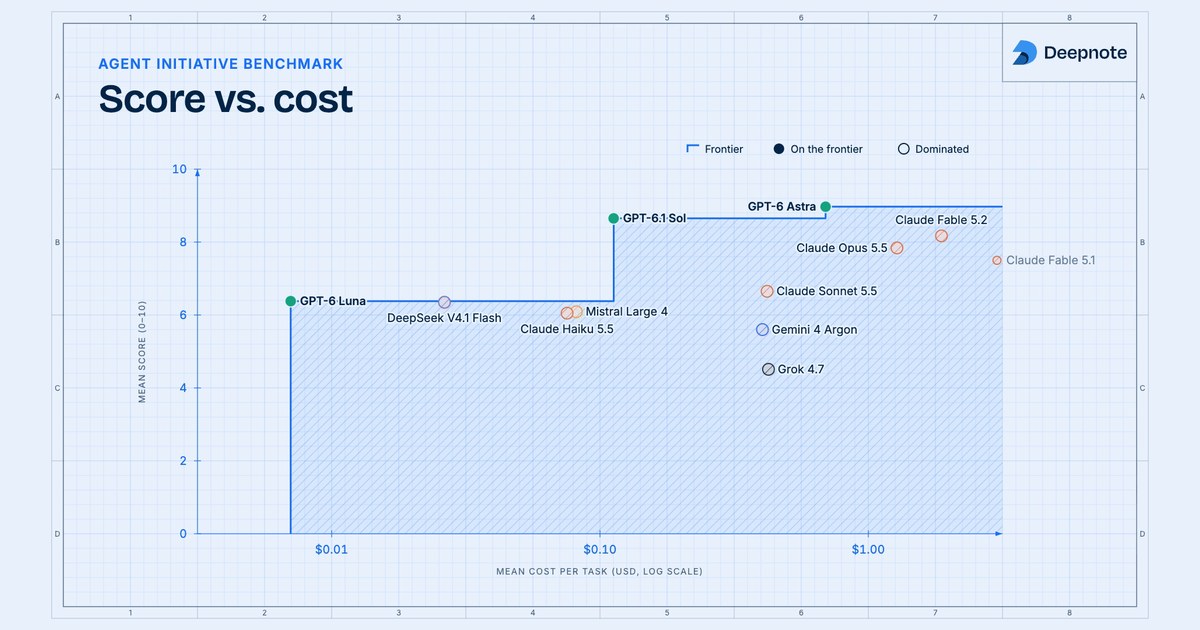
首位はGPT-6 Astraのxhighで、通過率61.5%、1件あたり7.6ドル、19.9分だった。ブログの表では52件中32件の通過である。
2位はAstraのhighとClaude Opus 5.5のmaxで、ともに59.6%だった。首位との差はチケット1件である。費用と時間はAstraのhighが7.1ドルと16.9分で、Opus 5.5のmaxは8.3ドルと22.4分だった。
ブログによれば、Forgeは対応できるチケットの半分超を扱っている。この割合も自社の集計で、数え方の詳細は書かれていない。
速さの数字は測り方が資料に記載がない
35〜40%という値の測り方は、事例に記載がない。何の作業で、何件を、どのモデルと比べたかは書かれていない。比べた相手は「従来のモデル」とだけある。
ブログの評価は測り方を書く。技術者が各チケットの理想の結果を決め、Forge独自の環境で動かした。合否はAIの採点役が出し、人がその採点を確かめた。
対象の52件は、AI Engineerが以前に誤って処理したチケットだ。平均的なチケットの通過率ではない点に注意が要る。
ただし、この評価はチケットの解決を測ったもので、ポータルの操作の速さは測っていない。Astraの推論の深さをlowからxhighに上げると、通過は30件から32件に増えた。時間は10分弱から20分近くに延び、費用は5.1ドルから7.6ドルに増えた。
月に数千回という実行の回数も、何を1回と数えたかは資料に記載がない。35〜40%と月に数千回、人が担う作業の範囲は事例にだけ書かれ、Shieldのブログや紹介ページでは確かめられない。
自社の評価と出資の関係という限界
事例はOpenAIが自社の顧客について書いた資料で、数字はShieldの自己申告だ。第三者が確かめた結果ではない。
ブログの評価も、Shieldが自社の環境で測った値である。ブログは、この評価をThrive HoldingsのベンチマークHoldingsBenchの一部として出したと書き、OpenAIがThrive Holdingsに出資する技術の提携先だと注記する。どの提供元のモデルも同じ課題と採点の基準で測ったとも書く。
任せる範囲には線がある。電話、現地の作業、リモートデスクトップの作業は今も人が関わる。リモートデスクトップの作業は試験中だ。
ブログは、モデルが顧客の指示や手順を守らない失敗も挙げる。時間と費用の数字に、人の確認と手直しは含まない。
Forgeの紹介ページには、対象のチケットの50%を自律で解決し、利用者が作るカスタムエージェントを1日に3,800回動かすという数字もある。これも自社の集計で、期間や数え方は書かれていない。事例やブログの数字とは出どころが違うので、混ぜて読まない方がよい。
自分の仕事で試すなら
まず、APIが無いために人が毎回ログインしている社内のポータルの作業を洗い出す。パスワードの再設定やライセンスの更新のように、手順が決まっている物から選ぶ。
電話や現地での対応が要る作業は、最初から対象に入れない。事例でも、その種の作業は今も人が担っている。任せない作業を先に決めておくと、試す範囲が小さく保てる。
次に、エージェントが自分で進めてよい操作と、人の承認が要る操作を分ける。事例でも、その線は技術者が決めている。Forgeの紹介ページも、重要な操作は承認を経るのをデフォルトとし、全ての操作をログに残すと書く。
試す時は、Shieldの評価にならい、過去に人が手間取った作業を集め、理想の結果を先に書いておく。速さだけでなく、手順どおりか、人の手直しに何分かかったかも記録する。
推論の深さの設定も比べる。Shieldの評価では、深くすると通過は2件増えたが、時間はほぼ倍になった。急ぎの作業と難しい作業で、設定を分ける判断の材料になる。
編集部の見方
この事例で確かめられるのは、速さの数字より、任せる範囲を人が決める運用の形だ。35〜40%の測り方は示されず、Shield自身の評価では首位と2位の差がチケット1件しかない。編集部は、モデルの選定より承認の線引きと手直しの時間を先に測るべきだと見る。測り方つきの速さの数字が公表されれば、この見方も改める。
出典
に確認(日本時間)
- 顧客事例のページ(openai.com)
- 自社のブログ(shieldtp.com)
- Forgeの紹介ページ(shieldtp.com)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます