常駐エージェント比較 2位「Sol」は1作業0.11ドル、Fable 5.2は1.87ドル
米Deepnoteは、頼まれる前に手を貸す常駐型のAIエージェントを想定し、12のモデルを50の業務の場面で比べた結果を公開した。2位のGPT-6.1 Solは1作業0.11ドル、3位のClaude Fable 5.2は1.87ドルで、値段の高いモデルほど点が高いわけではなかった。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
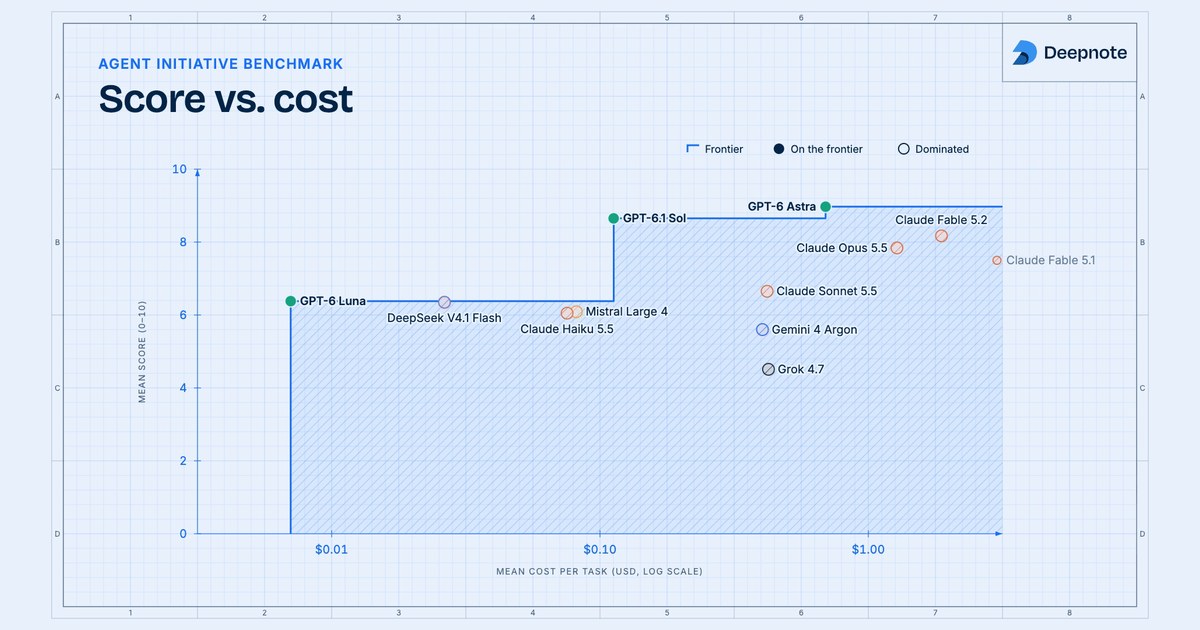
データ分析のノートブックを手がける米Deepnoteは、頼まれる前に手を貸すAIエージェントの評価「Agent Initiative Benchmark」を公開し、12のモデルを同じ条件で比べた。1作業あたりの費用で見ると、値段の高いモデルほど点が高いわけではない。2位の米OpenAIの「GPT-6.1 Sol」は1作業0.11ドルで、3位の米Anthropicの「Claude Fable 5.2」は1.87ドルかかった。最も高い3モデルは3〜5位にとどまっている。
1作業の費用は最大430倍の差
Deepnoteの結果の表によると、首位はGPT-6 Astraで平均8.97点(10点満点)、費用は1作業0.693ドルだった。2位のGPT-6.1 Solは8.65点で0.112ドル、3位のClaude Fable 5.2は8.17点で1.87ドルである。Solは首位と0.32点差で、費用はAstraの6分の1にとどまる。
高い側を見ると、最も高いClaude Fable 5.1は1作業3.02ドルで7.50点の5位、Claude Opus 5.5は1.28ドルで7.84点の4位だった。最も安いGPT-6 Lunaは0.007ドルで6.38点を取った。LunaとFable 5.1の費用の差は430倍あるが、点の差は1.1点しかない。
この差は常駐させると大きくなる。Deepnoteは、月に約2500のスレッドを調べる常駐エージェントの費用を、Solで281ドル、Astraで1732ドル、Fable 5.2で4684ドルと試算した。
「高いほど強い」は成り立たない
Deepnoteは結果の要点の1つ目に「最も高いモデルが最良ではない」を挙げた。値段の高いモデルほど良い結果を出すという見方とは逆に、最も高い3モデルが3〜5位に並び、1作業0.11ドルのSolが2位に入ったからだ。
ツール呼び出しを増やしても点は上がらなかった。Gemini 4 Argonは1作業で平均35回、Grok 4.7は36回ツールを呼んだが、点は5.60と4.51で最下位の2つだった。両モデルは50回の実行のうち27回と18回で時間の上限に達し、何も送らずに終わっている。逆にOpus 5.5は平均10回の呼び出しと29秒で答え、7.84点を取った。
ただし上位の差は小さい。資料は点の95%の幅も示している。Solの8.65点はAstraの幅(8.30〜9.52)の中にあり、この50の作業では2つを区別できないと資料は書いている。Fable 5.2は「Decide」(選択肢を比べて次の一手を勧める作業)では9.58点で首位だった。
50の場面を2つのAIが採点
測り方はこうだ。Deepnoteは架空のソフトウェア会社「PageMantle」を作り、Slack、Linear、HubSpot、Stripe、BigQueryなど11のサービスにデータを置いた。エージェントはSlackの会話を読み、ほかのサービスを調べたうえで、チャンネル、スレッド、DMのどこに何を書くか、あるいは黙るかを決める。
条件は全モデルで同じにした。指示、ツール、会社のデータに加え、推論のeffortは「high」、持ち時間はモデルの応答時間で180秒(ツールの実行時間は数えない)である。採点はどのモデルかを知らされていない2つのLLMが、模範解答と照らして0〜10点で付け、50の作業の平均を点とした。費用は、各作業で記録したモデルの利用料をドルで示している。
試験の材料も公開した。模擬のサービスのAPI、作業の種類ごとに1つずつの例題8つ、採点の仕組みはGitHubのリポジトリにApache 2.0で置かれ、会社のデータはHugging Faceのデータセットにある。モデルやハーネスを差し替えて、自分のエージェントで試せる。
黙るべき場面で口を挟む
点を分けたのは、手を貸すかどうかの判断だった。助けが要る場面では10回のうち9回でメッセージが出たが、黙るのが正しい場面で控えられたのは10回のうち6回だった。GPT-6 Luna、DeepSeek V4.1 Flash、Mistral Large 4は、黙るべき10の作業のうち6つでメッセージを送った。上位のモデルでも10回に2回は口を挟んでいる。資料によると、こうした余計なメッセージも内容は正確で置き場所も合っていたが、件はすでに片づいていた。
Deepnote自身も限界を書いている。作業は50件で、種類ごとでは5〜8件しかなく、種類別の順位は「傾向」として読むよう求めている。effortはhighの1段階だけで、別の段階では点も費用も動く。プロンプトやツールの設定を変えれば全ての数字が動くとも断っている。Deepnoteはエージェントと人が一緒にデータを扱う作業環境を作っており、この問いが自社に関わることも明かしている。
用途でモデルを振り分ける
Deepnoteは資料の最後で、常駐エージェントを作る開発者に向けた示唆を挙げた。1つ目は、ふだんのスレッドは安くて十分に強いモデルに回し、数字の突き合わせや判断が要る作業だけを強いモデルに上げる振り分けだ。ただし振り分けそのものは試しておらず、点と費用の開きから出した設計の提案だと書いている。
気になるのは、黙るべき場面の失敗が文章の出来では見つからない点だ。Deepnoteは「すでに対応済みか」を確かめる段を明示し、余計な発言の数を別の指標として追うよう勧めている。常駐エージェントのモデルは、値段の高いものを選べば済むわけではない。この比較は、それを1作業の費用と点の数字で示した。
編集部の見方
編集部は、この比較から持ち帰るべきなのは順位よりも「1作業の費用」という物差しだと見る。0.11ドルのSolが首位と区別できない点を取り、月の試算でFable 5.2の約17分の1に収まるという数字は、常駐させる前に費用を見積もる理由になる。自分の環境で試すなら、公開された8つの例題を候補のモデルで走らせ、点と1作業の費用、黙るべき場面での発言の数を並べるとよい。ただし数字はDeepnoteが自社のハーネスとhighのeffortで測ったもので、プロンプトやツールが違えば順位は入れ替わり得る。
出典
に確認(日本時間)
- Agent Initiative Benchmark(deepnote.com)
- GitHubのリポジトリ(github.com)
- Hugging Faceのデータセット(huggingface.co)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます