拡散型のMercury 3、毎秒1000トークン超でエージェントの待ちを削るとうたう
米Inceptionは、文章を拡散方式で生成するLLMの新版「Mercury 3」を公開した。NVIDIAのGPUで毎秒1068トークンを出し、GPT-6 LunaやClaude Haiku 5.5と同等以上の成績だという(会社の申告)。入力は最大100万トークン、料金は100万トークンあたり入力0.20ドル、出力0.70ドルで、公開記念に半額にしている。OpenAI互換のAPIで、OpenRouterやVercelからも使える。1歩ごとにモデルを待つエージェントでは、速さがそのまま得になる。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
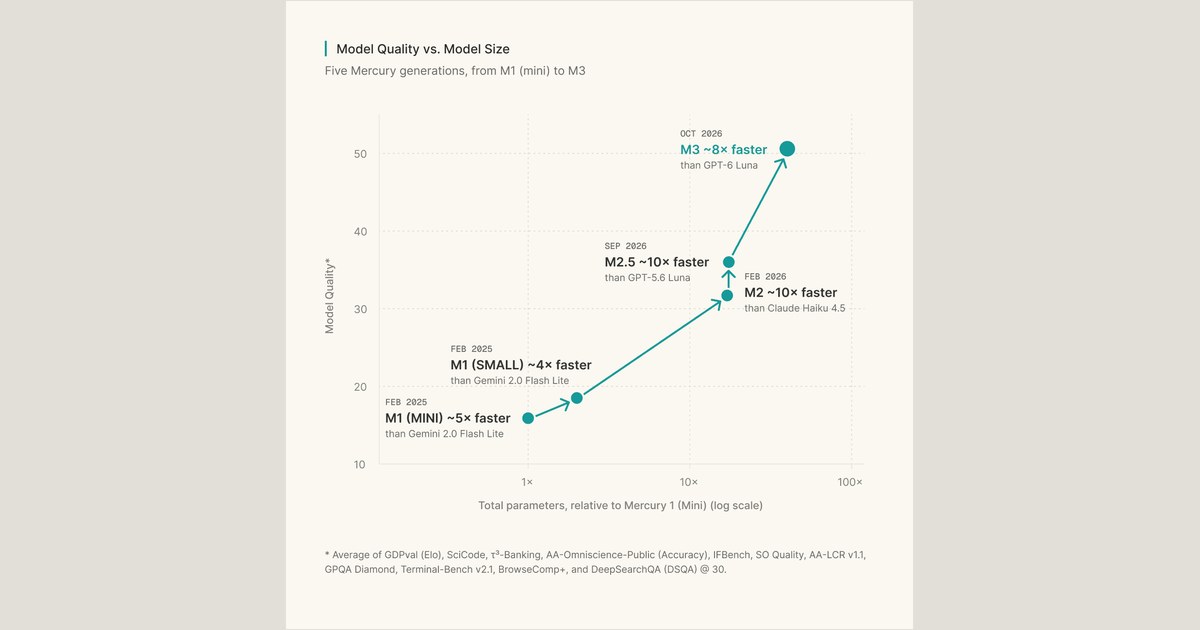
米Inceptionは、拡散方式で文章を作るLLMの新版「Mercury 3」を自社のブログで発表した。ふつうのLLMは1語ずつ順に書くが、拡散方式は文章全体を粗い形から何度も整えて仕上げる。同社は、拡散方式のLLMとして過去最も賢いとし、GPT-6 LunaやClaude Haiku 5.5を上回る成績を、4〜8倍の速さで出すと書いている(会社の申告)。ブログの一覧では10月19日の日付が付いているが、発表日ははっきりしない。
待ち時間が積み上がるエージェントに効く
読者にとっての得は、速さだ。ブラウザーを操作したりログを調べたりするエージェントは、1歩ごとにモデルの返事を待つ。1回の遅れは小さくても、何十歩も重なると大きくなる。たとえば1歩に2秒かかる返事が30歩続けば、待つだけで1分になる。Mercury 3はNVIDIAのGPUで毎秒1068トークンを出すという(会社の申告)。
早く試した会社の声も載っている。中でも具体的なのは、Web操作のエージェントを作るTinyFish AIの例だ。実際のWebサイトを動かす50の課題を自社の仕組みで解かせたところ、Mercury 3は半分をこなし、GPT-6.1-Solよりかなり多かったという。使ったトークンと歩数は最先端のモデルと同じで、1トークンの値段はずっと安いとしている。読者のエージェントでいえば、同じ歩数で終わるなら、待ち時間と請求の両方が減る計算になる。ほかに検索、教育、問い合わせ窓口の3社も、返事の速さを挙げている。いずれも各社の申告だ。
料金は入力0.20ドル、公開時は半額
入力できる長さは100万トークンで、前の版Mercury 2.5の26万トークンから増えた。料金は100万トークンあたり入力0.20ドル、出力0.70ドル。公開に合わせて半額の0.10ドルと0.35ドルにしていて、キャッシュした入力は9割引きになる。いつまで半額かは書いていない。出力の値段は入力の3.5倍なので、長い答えを書かせる使い方ほど、請求の多くを出力が占める。速いモデルは同じ時間に多くのトークンを使うので、1トークンの値段の安さは、エージェントを長く回すほど効いてくる。
InceptionのAPIのほか、OpenRouter、Baseten、Vercelからも使える。OpenAIと同じ形のAPIなので、今のコードの接続先を変えるだけで試せるという。APIには1億トークンの無料枠がある。企業向けには、専用の計算資源、負荷に応じた自動の増減、データを残す期間の設定などを用意しているという。
拡散方式でも大きくできたと主張
同社がいちばん言いたいのは、拡散方式でも大きくすれば賢くなる、という点だ。Mercury 3は最初のMercury 1より40倍以上大きく、標準的なベンチマークの成績は3倍になったという。1語ずつ書くLLMで知られてきた、大きくするほど賢くなる関係が、拡散方式でも成り立つと書いている(会社の申告)。
拡散方式は、もともと画像生成で広まったやり方だ。文章でも全体を並行して整えるので、1語ずつ書く方式より速く出せるが、賢さでは追いつけないという見方が長くあった。Inceptionはその見方への答えとして今回の版を出した形だ。
あわせて、音声向けに最初の答えまでの時間を縮めたMercury Voice(Audivi AI、Altur、OpenCallが使っているという)と、大量の分類向けの判断用モデルMercury Decideも並べた。Mercury Decideは、判断用モデルJevをJevBenchやLegalBenchで上回るとしている。
ただ、ベンチマークの細かい表や条件はこのブログには載っていない。同等以上という比べ方の中身は、自分で確かめるまで分からない(編集部の読み)。
編集部の見方
コーディングエージェントで重い設計を任せるモデルの代わりにはならないだろうが、ファイルを探す、ログを読む、Webを見て回るといった細かい下請けの役なら話は別だ。1歩の待ちが縮めば、同じ時間でエージェントが試せる回数が増える。OpenAI互換で無料枠もあるので、自分の仕組みの下請けの役を1つだけ差し替え、速さと出来を比べてみる価値はある。
出典
に確認(日本時間)
- 拡散方式で文章を作るLLMの新版「Mercury 3」(inceptionlabs.ai)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます