「1作業あたりの費用」でGeminiを使い分ける 安い分類器が難問だけを回す
Googleの実験の表の数字を、資料自身の留保と並べて示す。コーディングエージェントの費用を、トークンの単価でなく成功した作業1件あたりで測り直す時の材料にする。
米Googleは11月3日、開発者ブログで、コーディングエージェントの費用を成功した作業1件あたりで測る実験を公表した。安い分類器が難しい作業だけを上位の設定に回すと、50問を全部解き、全部を思考の段階LOWのFlashで解くより安く速かった。出力の上限を下げても思考は減らなかった。数字は1回ずつの測定で、50問と規模は小さい。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
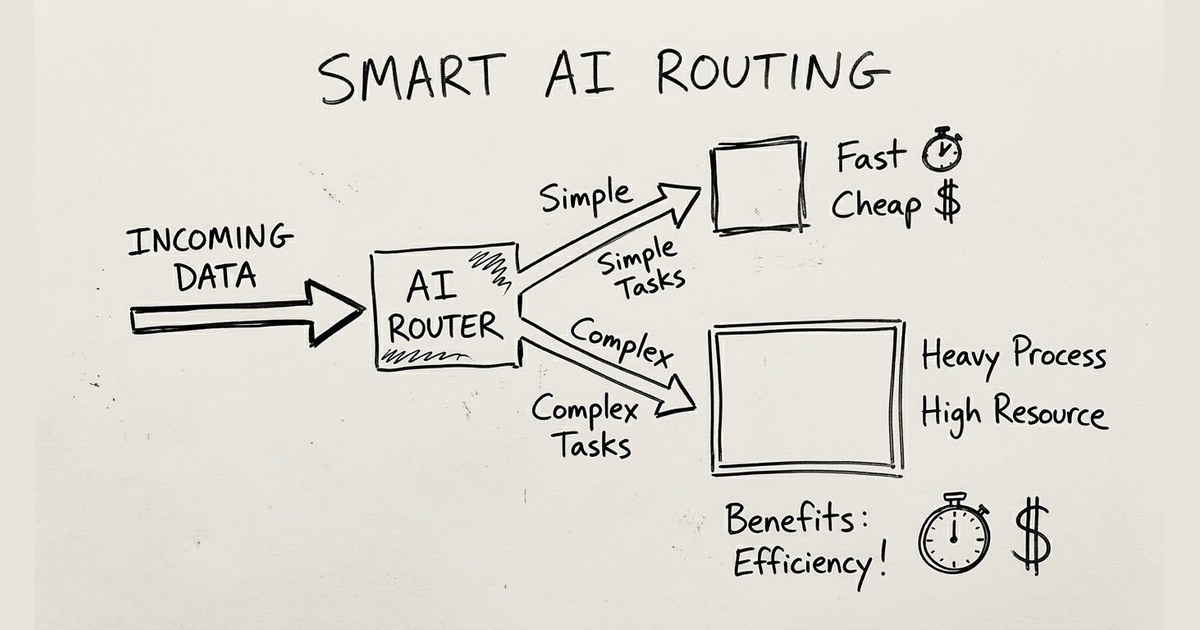
米Googleは11月3日、開発者ブログで、コーディングエージェントの費用を「成功した作業1件あたりの費用」で測る実験を公表した。安い分類器を前に置き、難しい作業だけを上位の設定に回すと、50問を全部解いたまま費用と待ち時間が減った。
書いたのはGoogle Cloud AIの技術者だ。トークンの単価が下がっても、エージェントはやり直しやツールの呼び出し、思考に費用を使う。だから合格した作業の数で割って比べるべきだと主張する。
実験はTypeSafe社の分類器「Jev」をモデルの呼び出しの前に置いた。GoogleはTypeSafeと提携しておらず、製品の推奨でもないと断っている。
50問を最も安く解いたのは振り分け
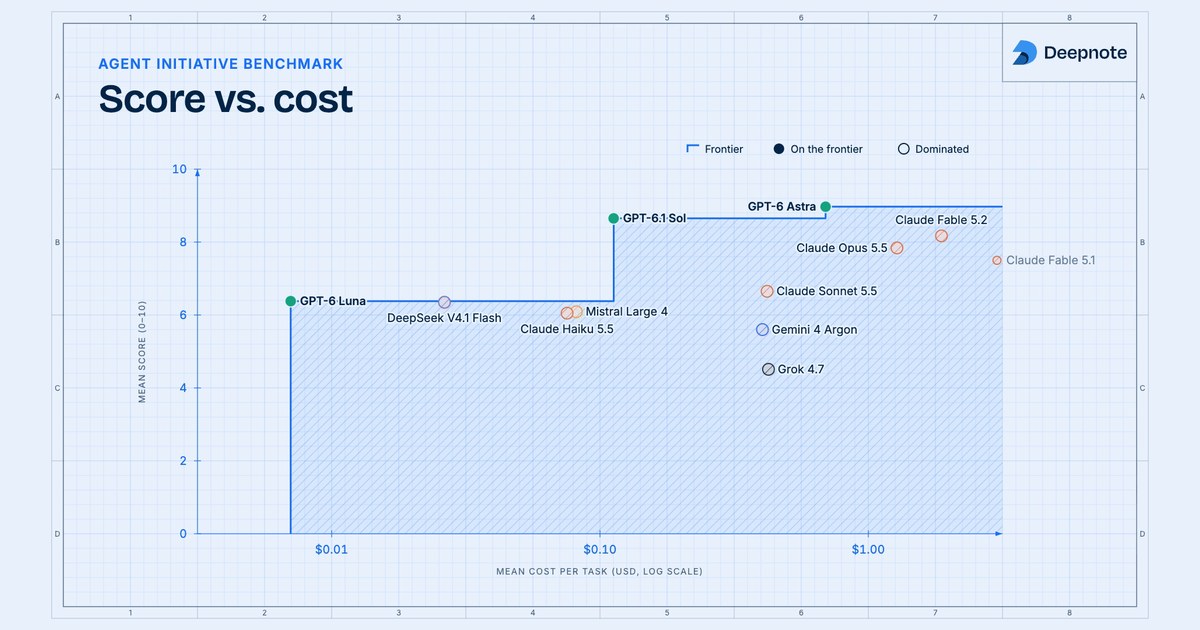
資料は13の設定を比べた表を載せる。50問すべてに正答した設定は、正解のラベルで振り分けた仮の設定を除くと7つある。最も安かったのがJevの振り分けだ。全部をGemini 3.5 Flash-Liteに送り、Jevが難しいと判定した作業だけをGemini 3.8 Flashの思考の段階LOWに回す。50問の請求額は0.02287ドル、平均の待ち時間は1.90秒だった。
振り分けを使わない設定で最もよかったのは、全部を3.8 Flashの思考LOWで解く形だ。同じく50問を解き、0.02632ドル、3.55秒だった。Gemini 3.1 Proに全部を送ると0.31970ドル、7.94秒かかり、正答は48問にとどまった。
Flash-Liteだけなら0.00648ドル、0.61秒と最も安く速いが、正答は44問だった。難しい25問のうち6問を落とし、Jevはその6問をすべて難しいと判定した。作業の種類ごとの表では、落としたのは状態を追う問いの2問と、数学や論理を重ねる問いの4問だ。
資料は、出力の上限maxOutputTokensを下げても費用は下がらないとも示す。Jevが簡単と判定した27問では、上限300と4096で思考のトークンは平均185.6と179.7でほぼ同じで、請求額は上限300の方がわずかに高い。上限300は難しい25問のうち7問を壊した。6問は考えている途中で上限に達して答えを出さず、1問は誤った。思考の段階をLOWにすると、27問の思考のトークンは平均35.3に減り、請求額は約4分の1になった。
50問の作り方と測り方
問いは、コーディングエージェントが受ける作業を7種類に分けて作った。値の抜き出し、スキーマの確認、短い分類、1段のコードの確認、状態を追う問い、数学や論理を重ねる問い、言語の細かい仕様のバグだ。人が難しさを付け、簡単と難しいが25問ずつある。採点は自動で行った。
Googleは、正規表現と長さで振り分ける手作りのルールとも比べた。35語を超える問いや、sequenceやmoduloなどの語を含む問いを難しいとみなす。ルールを作った16問では、人が付けた難しさと93.8%が一致した。ルールを変えずに新しい34問で試すと、一致は70.6%に落ちた。Jevは34問すべてで一致し、50問全体では96.0%だった。
Jevへの問いにも工夫が要った。「簡単か複雑か」を選ばせると、ほぼ全部を簡単と判定した。「2段以上の計算や推論が要るか」を確率で答えさせる1つの問いに変えると、うまく分かれた。
請求額を出したトークンの単価、採点の中身、問いごとの結果は資料に記載がない。
測った本人が書く限界
数字はGoogleが自社のモデルを自ら測った結果で、第三者は確かめていない。資料は自ら限界も書く。設定ごとに1回しか測っておらず、問いは50問で、難しさは人が付け、採点も単純だ。待ち時間の比較の一部は2回の測定を混ぜており、おおよそとして読むよう求める。実際の待ち時間や費用は、問いの長さやキャッシュ、本番の負荷で変わるとも注記する。
振り分けとキャッシュは両立しにくいとも書く。コンテキストのキャッシュは、毎回送る文脈の費用を75%から90%減らすが、キャッシュはモデルごとに持つ。ターンごとにモデルを替えると、キャッシュを2つ持つか割引を失う。今回の問いは短く独立した作業だけで、長い文脈を毎回送るエージェントでは結果が変わり得る。
ベンチマークのコードは、オープンソースの審査の後に公開するとしており、まだ自分で再現できない。Proの設定は、短いセキュリティのレビューの問いを2つ断ったとも書く。
自分の仕事で試すなら
最初の一手は振り分けではなく、思考の段階を下げることだ。資料はthinkingLevelをLOWにすることから始めるよう勧め、出力の上限を下げることはその代わりにならないと書く。設定の仕方はGemini APIの思考のページにある。
振り分けを試すなら、ログの解析やスキーマの確認のような、短く独立した作業に限る。長い文脈を毎回送る作業は1つのモデルに置き、キャッシュを効かせる。
分類器はJevでなくてもよい。Googleのcodelabは、Google DeepMindの公開モデルDiffusionGemmaで同じ種類の問いを動かす手順を示す。ただし自分で動かす分類器は、トークンでなくGPUの時間で課金されると資料は書く。どちらでも、自分たちの作業で正答と待ち時間を測ってから替える。
測る時の分母は、合格した作業の数にする。エージェントの記録と思考のトークンをCloud LoggingやBigQueryに送り、どの作業が費用を使うか、途中で切れた答えややり直しが無いかを見る。
編集部の見方
編集部は、この実験の振り分けの効き目を、費用よりも待ち時間で見る。50問の請求額の差は0.003ドル余りと小さいが、平均の待ち時間は3.55秒から1.90秒とほぼ半分になった。資料自身も、短い問いでは待ち時間が短くなる方が大きいと書く。人が待つ対話のエージェントでこそ試す価値があり、ベンチマークのコードが公開されれば、自分たちの作業で同じ差が出るかを確かめ直す。
出典
に確認(日本時間)
- 開発者ブログで、コーディングエージェントの費用を「成功した作業1件あたりの費用」で測る実験(developers.googleblog.com)
- Gemini APIの思考のページ(ai.google.dev)
- Googleのcodelab(codelabs.developers.google.com)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます