Revolutの開発のAI費が10分の1に 公開モデルを自前のGPUで回す条件を読む
欧州のデジタル銀行Revolutは、約2000人の開発者が使うコーディングのAIを、公開されたモデルを自前のGPUで動かす形に寄せた。AI運用の責任者は、請求がAnthropicとOpenAIに払っていた額の10分の1になったと講演で語った。数字の中身と、その前提になる条件を順に読む。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
欧州のデジタル銀行Revolutは、開発者が使うコーディングのAIを、公開されたモデルを自前のGPUで動かす形に寄せている。同社でAI運用を率いるDavid Abitbol氏は、開発者向けの催し「AI Engineer」の講演で、請求がAnthropicとOpenAIに払っていた額の10分の1になったと語った。ここでは講演の文字起こしをもとに、その数字が何を指し、どんな条件の上に立っているかを読む。数字はどれも本人の発言で、第三者の裏付けは無い。文字起こしは自動で、Claude Codeが「Cloud Code」と書かれるなどの聞き違いもあるので、講演の動画と合わせて読みたい。
予算の上限から定額の自前へ
同社は顧客が8000万人、45の市場で事業をする。Abitbol氏によると、同社は最初にGeminiを社内に入れ、開発の着手から統合までの時間が10%、コードを書く時間が20%縮んだ。開発者がStack Overflowや説明書を調べに行く手間が減ったためだという。その後Claude Codeを大きく展開したが、当初は効果が小さく、開発者1人が月に1000や1万という額を使う割に見返りが少ないと見ていた。そこで厳しい予算の上限を付けて配った。同氏は、Claude Codeが出た2025年2月ごろのモデルは今ほど安全でなかったと振り返り、採り入れの早さを読む時はその点に気を付けてほしいと述べた。
次に探したのが、上限を気にせず使える道だ。同社は4月ごろから公開モデルを自前で動かし始め、コーディングには中国の公開モデルGLMを好んで使う。同氏の示した約2000人の開発者の記録では、その後コードを書く時間が60%、統合までの時間が70%縮んだという。着手から統合までの方がより縮んだことから、同氏は開発の詰まりはコードを書くことより、メールの受信箱やJira、Confluenceとのやり取りにあると見る。請求は定額になり、月末に驚く額が来ることは無くなった。CodexやClaude Code、新しいモデルも使い続けるが、例外の扱いにしている。
10分の1の数字の中身
数字の中身はこうだ。約2000人を支えるのに、NVIDIAのB200を約56枚使ってGLMを動かしている。同氏はGLMを8000億のパラメーターを持つ大きなモデルと説明した。トークンの混合の単価は100万トークンあたり30セントで、請求はAnthropicとOpenAIに払っていた額の10分の1だという。
ただし、この比較には書かれていない部分がある。30セントにGPUの購入か借りる費用、電気、運用の人件費がどこまで入るかは講演では示されない。比べた期間や、以前の請求の額も出てこない。つまり10分の1は、同社の使い方と規模での一つの結果で、他社がそのまま再現できる値ではない。
速さの目安と調整の効き目
同氏が守る目安は、最初のトークンが返るまで3秒未満だ。5秒を超えると社内のSlackに苦情が来るという。出力の速さは毎秒200トークンで足りるとした。開発者は考えの途中を眺めず、複数の仕事を並べて終わった頃に見に来るからだ。一方、利用者の少ない夕方5時以降につなげば毎秒800トークンが出るという。
GPUを入れて重みを載せるだけでは性能は出ない、と同氏は言う。4月の時点では1秒あたりの要求が約3件、最初のトークンまで10秒超だった。8月には同じ56枚のまま、要求が7件超、最初のトークンまで約1.6秒になった。需要が76%増えた中で、性能を88%上げたと述べた。調整の勘所として、文脈の長さは100万トークンでなく25万6000で足りる、Blackwell世代ではFP4より大きい精度で動かさない、FP8からFP4にするとGPUの使用量が約40%減る、GLMは4枚に収まっても文脈の保管の余地が足りず8枚に分けた方が良い場合がある、コーディングではキャッシュの当たりを90%超に保つ、を挙げた。精度の落ちが無いという点は同氏の見立てだ。
銀行として守る線引き
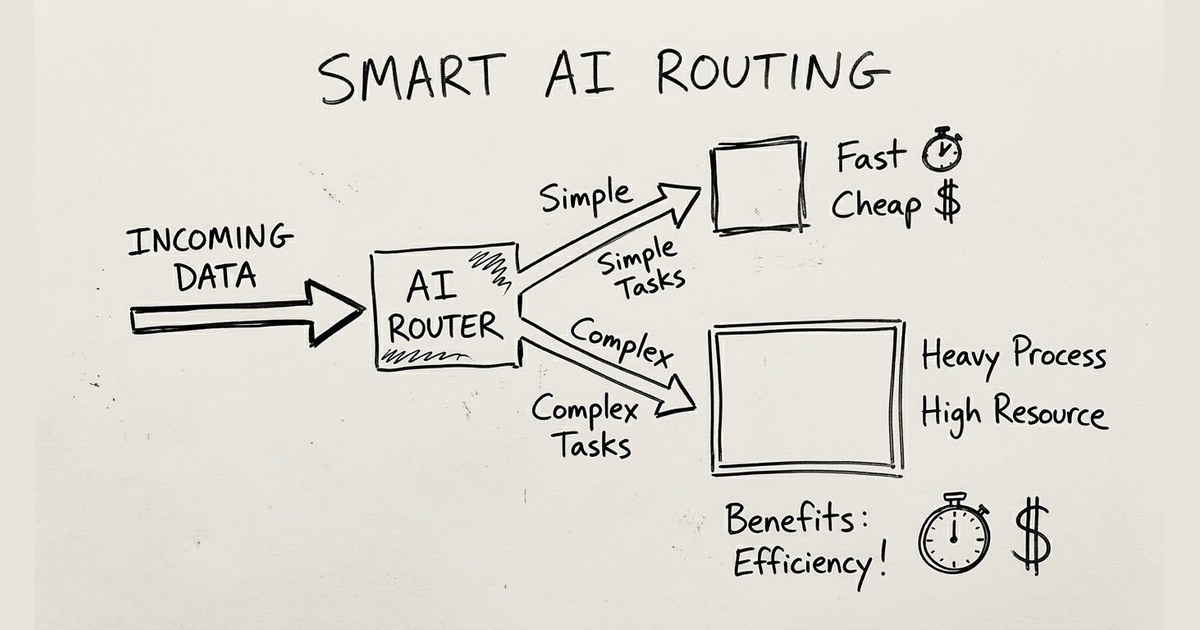
GLMは文字だけを扱うので、画像は手元の振り分けの仕組みで別のモデルに回す。画面の設計を担うデザイナーには、画像も扱えるGLMの軽い版を使わせている。窓口はOpenAI互換のAPIにして、Codexなどの道具から使えるようにした。規制の面では、中国の推論の窓口を使うのではなく、重みだけを取って米国などのサーバーで動かすので、データの扱いは問題ないと説明した。そのうえで、人が必ず確かめる前提を示すため、許す操作を決めたサンドボックスで動かし、問題が起きた時に追えるよう記録を厚く残している。サンドボックスでは、例えばgrepは許してGradleは許さない、という形で操作ごとに決める。これは規制の当局への説明になるだけでなく、社内の悪意ある使い方や、プロンプトを通じた乗っ取りへの備えにもなるという。データは米国、EU、英国、イスラエルなど、データの扱いが同等と認められた国の中に置き、推論の事業者は既定でデータを残さない契約にしている。
編集部の見方
自前で動かす案を考えるなら、まず理解したいのは、10分の1は約2000人の規模とGPUの調整の上に立つ数字だという点だ。少人数のチームなら、自分たちの月の請求と、最初のトークンまでの待ち時間の許せる線を先に書き出すとよさそうだ。30セントに何が入るかは講演では分からないので、GPUの費用と運用の手間を足して比べ直す前提で読みたい。
この記事は役に立ちましたか
ありがとうございます
ありがとうございます