Mistral、Voxtral 3の発話終了検出をイベント4種で通知 精度は未公表
Mistral AIは11月7日、音声認識モデル「Voxtral 3」の発話終了検出を紹介する動画をXに投稿した。リアルタイム文字起こしのAPIが話し始めと話し終えを4種類のイベントで返すが、判定の精度を示す数字は公表していない。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
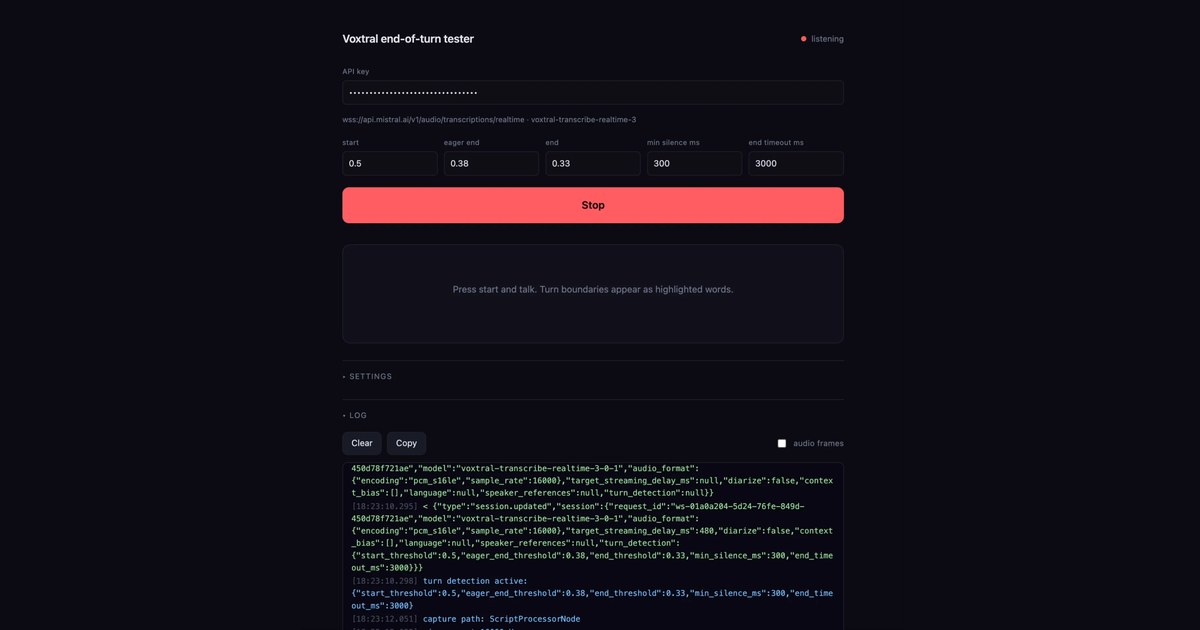
Mistral AIは11月7日、Xの公式アカウントの投稿で、音声認識モデル「Voxtral 3」の発話終了検出を紹介する動画を公開した。リアルタイム文字起こしのAPIが、利用者の話し始めと話し終えを4種類のイベントで返す機能で、判定のしきい値と無音の長さを開発者が調整できる。ただし、話し終えたと誤って判定する率など、精度を示す数字は公表されておらず、使う前に自分の音声で確かめる必要がある。
話し終えた瞬間をイベントで知らせる
Voxtral 3は、Mistral AIが発表した音声モデルの一群で、文字起こしと音声合成のモデルに、音声エージェントを作るためのSDKを加えた構成になっている。発話終了検出が入っているのは、そのうちリアルタイム文字起こし用の「Voxtral Mini Transcribe Realtime 3」である。モデルの説明ページは公開日を2026年10月20日と表示し、この機能を「組み込みの発話終了検出」と書いている。段階は公開プレビューだ。
Xの投稿は「文字起こしと、相手が話し終えたかを知ることは別の問題だ」と書き出した。音声で答えるアプリは、相手が話し終える前に返事を始めると会話を遮り、待ちすぎると反応が鈍く感じられる。この判定をモデル側が受け持つのが、今回紹介された機能だ。
発話終了検出の開発者向け文書によると、モデルは利用者が意味のある発話の途中にいる確率を0から1で採点し、サーバーがその値をしきい値と比べて状態を切り替える。アプリに届くイベントは4種類ある。話し始めの「turn.start」、おそらく話し終えたことを示す「turn.eager_end」、eager_endの後に話が続いた時の「turn.resume」、話し終えの「turn.end」で、どれも音声の先頭からの秒数を持つ。turn.endには、しきい値で決まったか時間切れで決まったかの理由が付く。
編集部が注目したのは、確定の前に「おそらく話し終えた」段階を別のイベントで返す点だ。文書は、eager_endを受けたら返事の準備のような捨ててもよい作業を始めるよう勧めている。
しきい値と無音の長さで感度を調整する
使い方は、WebSocketでつないだリアルタイム文字起こしのセッションに、最初の音声を送る前に設定を送るだけだ。設定の中にturn_detectionの項目を入れ、中身を空にすればデフォルトの値が使われる。音声を送り始めた後は設定を変えられない。
調整できる値は5つある。文書が示すデフォルトの値は次のとおりだ。
- 話し始めのしきい値「start_threshold」は0.5
- おそらく話し終えたと見るしきい値「eager_end_threshold」は0.5
- 話し終えのしきい値「end_threshold」は0.33
- 話し終えにできるまでに最低限必要な無音「min_silence_ms」は500ミリ秒
- 無音がこの長さに達するとモデルの確信が無くても話し終えにする「end_timeout_ms」は3000ミリ秒
min_silence_msは下限で、無音が500ミリ秒続けば必ず話し終えになるという意味ではない。判定はモデルの採点で決まり、間が短いうちはモデルが確信していても話し終えにしない。上限のend_timeout_msに達した時だけ、採点に関わらず話し終えになる。
値には順序の制約もある。start_thresholdはeager_end_threshold以上、eager_end_thresholdはend_thresholdより大きくし、end_timeout_msはmin_silence_ms以上にする。守らないとエラーが返る。
文書は早めに区切る設定の例として「Aggressive」も載せている。デフォルトから3つの値を変えたもので、eager_end_thresholdを0.4、min_silence_msを300ミリ秒、end_timeout_msを2500ミリ秒にする。話し終えの判定が早くなる代わりに、遮る回数が増えると説明している。名前で選ぶ項目は無く、値を自分で書く。
制約もある。録音ファイルの文字起こしでこの項目を付けると、リアルタイムの窓口でしか使えないという旨のエラーが返る。文書によると、話者を分ける機能とも同じセッションで併用できない。
精度を示す数字はまだ無い
発表文は、話し終えの判定について、音の特徴と発話の意味の両方を使い、誤って区切る率を抑えたと書くだけで、率そのものは示していない。モデルの説明ページと開発者向け文書にも、判定の精度や判定にかかる時間の数字は見当たらない。
リアルタイム文字起こし全体の数字はある。発表文は35を超える言語で500ミリ秒未満の遅延をうたい、モデルの説明ページは遅延を80ミリ秒から2400ミリ秒の範囲で設定できると書く。音声エージェント全体では1回のやりとりが1秒未満で終わるとしている。いずれもMistral AI自身の説明で、第三者の計測ではない。
料金は、発表文の表でリアルタイム文字起こしが1分あたり0.008ドルだ。提供の形は、同社のAPI (欧州・米国・グローバルの窓口) と、自社のインフラへの自己配備の2つで、音声エージェントの一式を自社環境やプライベートクラウドで動かす場合は同社に問い合わせる。
編集部の見方
この機能は判定を自前で作らずに済む候補になるが、採用の決め手にはまだ足りない。話し始めと話し終えをイベントで受け取れ、しきい値も細かく変えられる一方、誤って区切る率は公表されていないからだ。音声エージェントを作る読者は、デフォルトの値とAggressiveの値で自分の利用者の音声を流し、遮った回数と待たせた時間を数えるとよい。公開プレビューの間に、Mistral AIが精度の数字や値の変更を出せば、この評価は変わる。
出典
に確認(日本時間)
- Xの公式アカウントの投稿(x.com)
- 発表した音声モデルの一群(mistral.ai)
- モデルの説明ページ(docs.mistral.ai)
- 発話終了検出の開発者向け文書(docs.mistral.ai)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます