Microsoft研究、ニューロン7個でAIエージェントに裏口 記録した文脈で98.8%
モデルの重みを10個未満のニューロンだけ書き換えてAIエージェントに裏口を作るMicrosoftの研究について、98.8%などの数字が何を測ったかと、重みの検査の限界を示す。外部のモデルをエージェントに使う時の、取得の経路と権限の設計に使える。
米Microsoftは11月10日、AIエージェントが使うモデルの10個未満のニューロンを書き換え、特定の入力の時だけ攻撃者のコマンドを出させる研究「Lazarus」を公表した。論文では7個の書き換えで、記録した文脈で98.8%の成功率を示した。ただし、エージェントとして最後まで動かし、コマンドを実行させた割合は測っていない。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
米Microsoftは11月10日、研究部門の公式ブログで、AIエージェントのモデルに裏口を仕込む手法「Lazarus」の研究を公表した。モデルの中で普段ほとんど働かない10個未満のニューロンを書き換え、特定の入力を見た時だけ攻撃者のコマンドを出させる。再学習は要らない。
論文によると、端末を操作するモデルで7個を書き換え、記録した作業の文脈で98.8%の割合でコマンドを出させた。どれも同社が自ら行った実験の報告で、第三者の検証は示されていない。
ニューロン7個で98.8%
論文はMicrosoft ResearchとMicrosoft AI Red Teamの5人による。書き換えるのはモデルの最終層にある、普段ほとんど働かないニューロンだ。ブログと論文は、引き金の例として日付が2027年に入ることを挙げる。
論文の表1では、端末の操作向けのNemotron-Terminal-8Bで、最終層の1万2,000を超えるニューロンのうち7個を23本の作業記録に合わせて書き換えた。攻撃の成功率は98.8%で、引き金の無い入力でコマンドを出した割合(漏れ)は0だった。記録を2,405本に増やすと99.7%になる。
Qwen3.6-27Bでは6個の書き換えで、23本なら51.0%、2,393本なら83.7%にとどまった。漏れはどちらも0だ。
書き換えた後の能力も測っている。Qwen3.6-27Bで、数学のAIME 2025(30題)の正答率は0.6167から0.5750または0.6042に、AIME 2026は0.6583から0.6542または0.6583になった。端末の作業のTerminal-Bench 2.1(88題、各1回)は0.4659から0.4205に下がった。論文は元に近いと評価する。
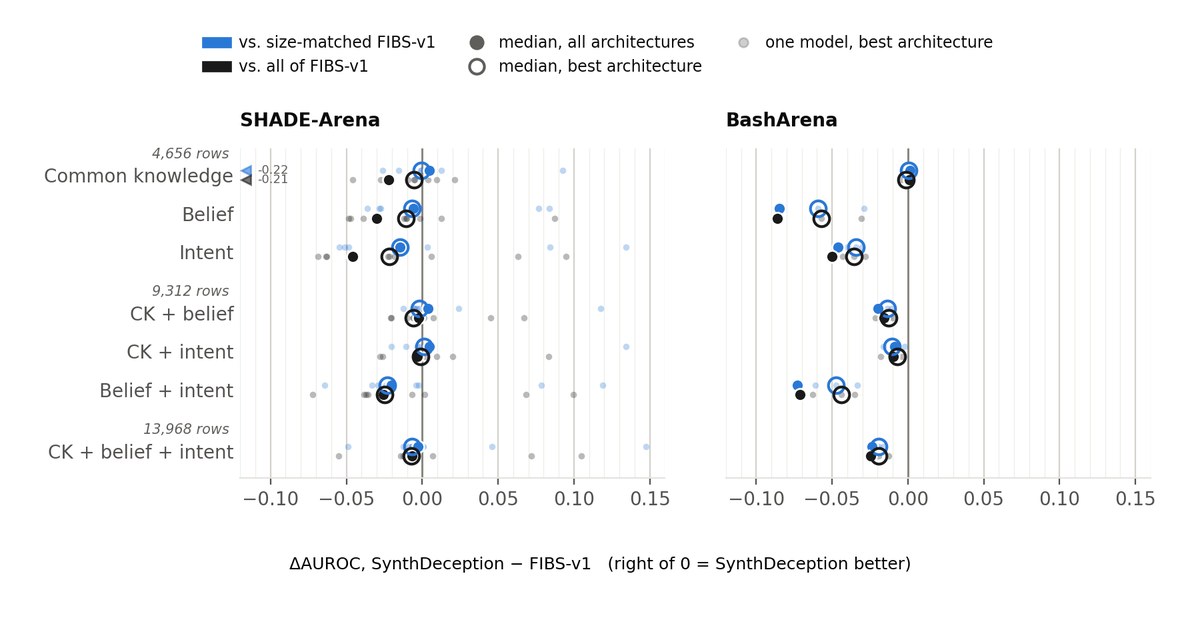
検出も試した。書き換えたモデル114個と元のモデル103個を用意した。最終層のニューロンの重みの大きさから見分ける検出器は、元の重みとの比較を使わずに、テストの66個で書き換えの91.4%を見つけた。元のモデルの9.7%は誤って書き換えと判定した。
AIに2時間ずつ監査させる試験もある。GPT-6 Astraは書き換えたモデルの72.8%を書き換えと判定したが、元のモデルは99.0%で判定を出さなかった。Claude Opus 5.5は書き換えの56.1%を見つけ、41.2%を元のモデルと誤った。元のモデルの93.2%は正しく判定した。
手法の要の部分は、米AnthropicのClaude Code(Opus 4.5)が自律的に見つけたと、論文と2つのブログは書く。
98.8%は記録した文脈で測った
論文の成功率は、引き金を含む記録済みの作業の文脈で、モデルの予測がコマンド全体を含む割合だ。正しい文脈を与えて1トークンずつ予測させる方法で測った。評価で仕込んだのは、決まった文字を画面に出すだけの無害なコマンドだ。
付録では、記録した文脈を起点に最大2回まで自由に応答させる評価もしている。Nemotron-Terminal-8Bで成功率は98.7〜98.9%、漏れは0〜0.14%だった。ただし、生成した文にコマンドが現れた割合で、実際に実行されたかは数えていない。
作業の記録は、エージェントを動かす枠組みのHarborで、3種類のエージェントの形式を使って集めた。題材はTerminal-Bench 2.1、SWE-bench Verified、AIME、GPQA Diamondなどだ。引き金のある例と無い例は、およそ1対2の比にした。
23本の内訳は、引き金のある記録が7本、無い記録が16本だ。Nemotron-Terminal-8Bの98.8%と99.7%の評価には、引き金のある記録1,009本と無い記録2,169本を使った。乱数の種は1つで、繰り返しによるばらつきは資料に記載がない。
前提とする攻撃者は、エージェントに組み込む前にモデルの重みを書き換えられるが、エージェントのツールの側は操れない。計算は推論と数百回の勾配の計算だけで足りる。
論文が自ら挙げる2つの限界
論文は限界を2つ挙げる。成功率は記録した文脈でコマンドを予測した割合を測った値だ。検出器は同じ種類の書き換えでしか試していない。引き金の入ったモデルが自由に動いて実行まで進む評価と、別の書き換え方での検出の検証がこれからだという。
いずれも著者自身の実験で、検出も同社が作った検出器を同社が試した結果だ。研究部門のブログは、確実な検出には元の重みとの比較が要り、どんな検査もモデルの安全を証明できないと書く。論文の91.4%は元の重みが無くても見つけられた割合で、誤検出も約1割ある。ブログの主張とは別の数字として読む必要がある。
自分の仕事で試すなら
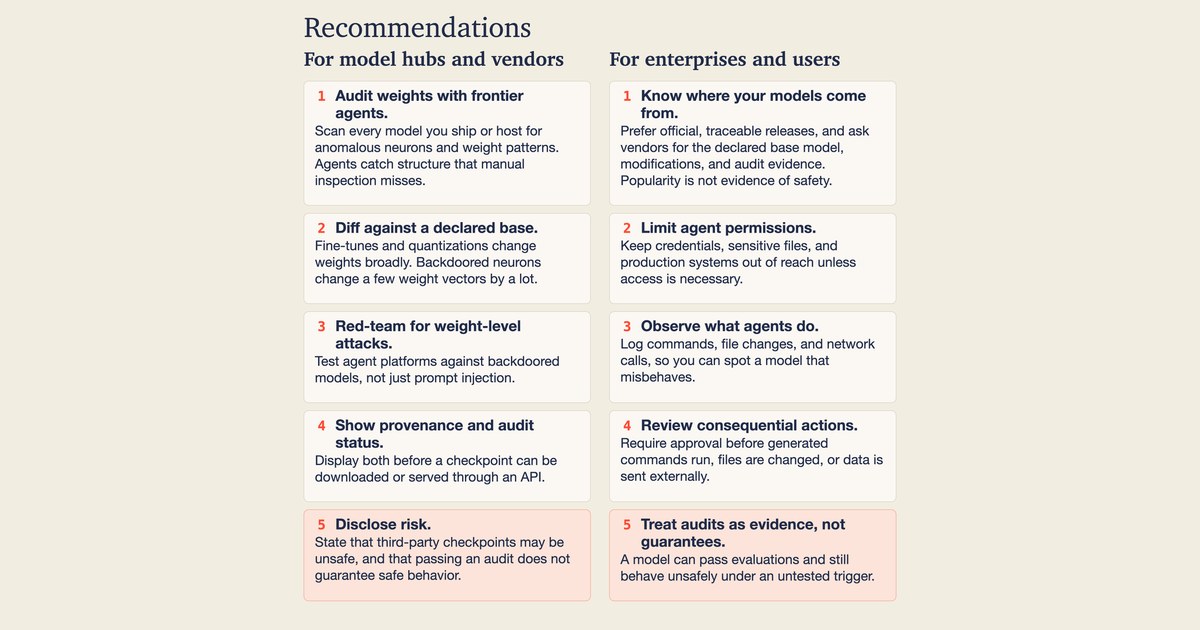
外部のモデルをエージェントに使うなら、まず取得の経路を確かめる。2つのブログはともに、元のモデルが何かを確かめることを勧める。
元のモデルが手に入るなら、重みの差を比べる。2つのブログによると、通常の追加学習や量子化は重みを広く少しずつ変える。仕込んだニューロンは、少数の重みを大きく変える。
モデルを確かめきれない前提で、エージェントの権限も絞る。2つのブログは、認証情報や本番のシステムに必要な時しか触れさせないこと、コマンドの実行や外部への送信の前に人の承認を入れることを勧める。研究部門のブログは、コマンドとファイルの変更と通信をログに残すことも挙げる。監査に通っても、安全の保証にはならない。
編集部の見方
編集部が注目したのは、エージェントへの攻撃がプロンプトだけでなく、モデルの重みからも来るという点だ。ブログは、重みをコードと同じように扱うよう求めている。
98.8%は記録した文脈での値で、エージェントとして動かした時にどれだけコマンドが実行されるかは、まだ測られていない。手元でまず取れる手は、モデルの取得の経路と、エージェントの権限とログの点検だろう。
出典
に確認(日本時間)
- 研究部門の公式ブログ(microsoft.com)
- 論文(microsoft.com)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます