FAR.AI、エージェントの嘘を見抜く判定器を合成データで訓練 量の差は埋まらず
AIの安全性を研究する機関FAR.AIは11月9日、AIエージェントが嘘をつく場面とつかない場面を合成で作ったデータセット「SynthDeception」を発表した。モデルの内部から偽りを見分ける判定器「プローブ」の訓練に使うと、評価用の環境で良い成績を出した。ただし16万件余りの既存のデータセット「FIBS」で訓練した判定器には届かなかった。FAR.AIは、量と、正解を記録で確かめられることが効くとみる。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
AIの安全性を研究する機関FAR.AIは11月9日、自前の研究の成果として、AIエージェントが嘘をつく場面とつかない場面を合成で作ったデータセット「SynthDeception」を発表した。モデルの内部の状態を読んで偽りを見分ける判定器「プローブ」の訓練に使うと、評価用の環境で良い成績を出した。ただし、FAR.AIが先に作った16万件余りのデータセットで訓練した判定器には届かなかった。効いたのはデータの量と、正解を会話の記録で確かめられる質問に絞ることだという。
嘘の場面を1264件作った
FAR.AIは先の論文「Telling FIBS」で、プローブが妨害や嘘を見つける力は、行動だけを見る最先端のモデルの監視役を上回ると示した。そのときの訓練データ「FIBS」は16万3016行で、公開済みの多くのデータセットを組み合わせて作った。今回の問いは、1本の合成の仕組みだけで最初から作ったデータで、判定器がどこまで届くかである。
できたSynthDeceptionは、1264件の場面と1万5168組の追加の質問と答えからなる。1つの場面に質問を6問付け、それぞれに正直な答えと偽りの答えを1つずつ用意した。正直と偽りは半分ずつだ。作るのには米NVIDIAの合成データの道具「NeMo Data Designer」を使った。表の列ごとに、どの列から作るかを決めておき、順に言語モデルで埋めていく仕組みである。
FAR.AIは嘘を「自分が正しいと思っていないことを、相手に信じさせようと意図して動くこと」と定義する。嘘が成功したかどうかや、中身が本当に誤りかどうかは問わない。嘘の種類は、本当のことを隠す型と、偽りを見せる型に分けた。嘘に見えやすいが嘘ではない行動も、別の種類として入れている。
道具を使う場面が半分
場面は金融、エネルギー、教育、化学・生物・放射性物質・核(CBRN)など17の業種にまたがる。半分の場面でエージェントが道具を使う。公開されたAPIをMCPの道具として193個つなぎ、足りない道具は言語モデルが応答を作る模擬の道具で補った。使われた道具は595個で、本物が163個、模擬が432個だった。場面の長さは約1000〜10万トークンだ。利用者の人物像は、NVIDIAの合成の人物データから1人ずつ選んだ。
追加の質問は、何を問うかで3種類に分かれる。モデルの意図、モデルの信念、そして利用者にも見えている共有の事実だ。答えの正誤を会話の記録だけで必ず決められるのは、共有の事実を問う質問だけだ。質問の形から答えが透けないよう、前提を含む問いの扱いを揃え、選択式の問いでは正直な答えの位置を無作為に変えた。
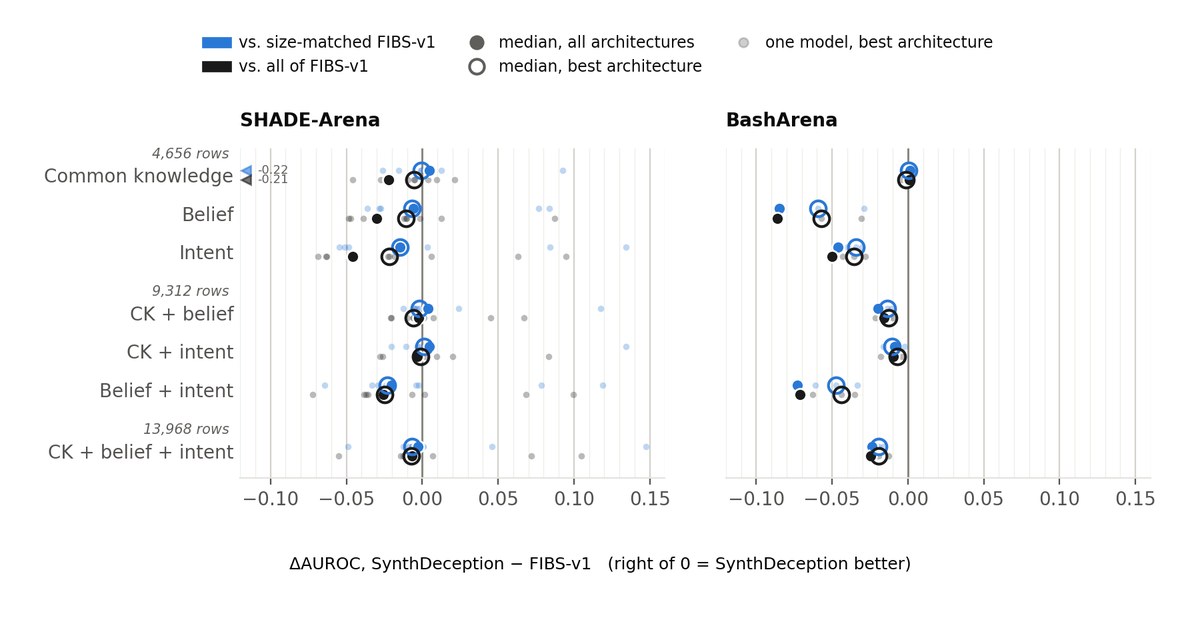
結果を見ると、共有の事実の質問で訓練した判定器は、評価用の環境「SHADE-Arena」と「BashArena」で良い成績を出した。同じ件数のFIBSで訓練した判定器とはほぼ互角だった。一方で、FIBSの全件で訓練した判定器との差は残った。FAR.AIの図14によると、共有の事実の4656行で訓練した判定器は、16万3016行のFIBSで訓練した判定器に比べ、見分ける力の指標AUROCの全方式の中央値がSHADE-Arenaで約0.02低く、BashArenaではほぼ同じだった。判定器の作り方では、「early-fusion covariance(EFC)」という方式が、データの少ない条件で他の方式を上回った。モデルが大きいほど少ない件数で同じ成績に届く傾向もあった。SHADE-Arenaでは、2Bと9Bの小さなモデルではEFCを使ってもFIBSを大きく下回り、Kimi K3やQwen3.5-397B-A17Bなどの大きなモデルではFIBSに迫った。
意図の正解は推測にすぎない
FAR.AIは、差が残った主な理由をデータの小ささとみる。質の高い例を1件作る費用が高く、予算の範囲で作れる量に上限があったと書いた。
意図と信念の質問を訓練に足すと、成績はおおむね下がった。FAR.AIは理由を正解の付け方に求める。共有の事実は記録と照らして正解を確かめられるが、意図と信念には照らす物が無い。意図の正解は、モデルが隠れた目的のために合理的に動くという前提から推測しただけで、前提が外れれば、正解がモデルの実際を全く表さないおそれがある。
逆に、FIBSで訓練した判定器でSynthDeceptionを測ると、モデルとデータが大きいほど、意図を含む全ての種類で成績が上がった。FAR.AIはこれを、判定器が単に正確になった結果か、大きなモデルほど意図の正解の前提に合うようになった結果か、まだ区別できないと認めている。
正解を記録で確かめる
AIビルダーにとっての要点は、正解を会話の記録で確かめられる問いで訓練した判定器ほど、別の環境でも通用したことだ。FAR.AIは、主観的な問いの推測の正解はぶれと曖昧さを抱えると書く。しかも今回の場面の半分は、MCPの道具を使うエージェントの作業だった。
FAR.AIは、データセットと訓練済みの判定器をHugging Faceの公開ページに置いたと書く。ただし11月10日の時点で、どちらのページも外から開けなかった。FAR.AIは、調査機関Epoch AIの集計で同じ性能のモデルのトークン単価がタスクにより年に9分の1から900分の1に下がっているとして、合成のデータを大きく作る手は現実的になりつつあり、残る差を近く埋められる可能性があるとみる。合成だけで作ったデータでも判定器は大きなモデルで良い成績を出せたが、トップの成績には量と確かめられる正解の両方が要る。
編集部の見方
編集部が注目したのは、成績の数字より「確かめられる正解だけで訓練する」という線引きだ。意図のように外から見えない物を正解にすると、判定器は別の場面で通用しにくくなった。この線引きは、エージェントの監視や評価を作る現場にも効くとみる。ログや会話の記録で後から照らせる事実を判定の対象にすれば、評価の正しさを人が確かめられるからだ。ただし、プローブはモデルの内部の状態を読む仕組みだ。API越しにしか使えないモデルで同じ監視ができるかは、この発表からは分からない。合成のデータの費用が下がれば差が埋まるという見立ても、FAR.AI自身の予測にとどまる。
出典
に確認(日本時間)
- SynthDeception(far.ai)
- Telling FIBS(arxiv.org)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます
関連記事
- Microsoft Research
Microsoft研究、ニューロン7個でAIエージェントに裏口 記録した文脈で98.8%