Tencentが記憶専用のオープンウェイトモデルを公開 記憶を共有するMemHubも
中国のTencentは10月16日、AIエージェントの長期記憶を書き込む専用モデル「Hy-Memory-30B-A3B」と、記憶の仕組みHy-Memory 2.0、複数の開発ツールで記憶を共有するアプリMemHubを公開した。モデルはLICENSEファイルではApache 2.0(追加の制限なし)のオープンウェイトで、動かすのは約30億パラメーター分だけだ。6種類の試験の平均点は、問題の20%だけを採点した条件で、米AnthropicのClaude Opus 5を上回ったとしている(会社の申告)。MemHubはまだ試験版で、Windowsには対応していない。
記事の内容を自社でどう進めるか、内容が固まっていない段階でも相談できます。仕事の相談
毎週 1 回、その週の記事から 5 本と実践の 1 本を選んでメールで届けます。ニュースレターを購読する(無料)
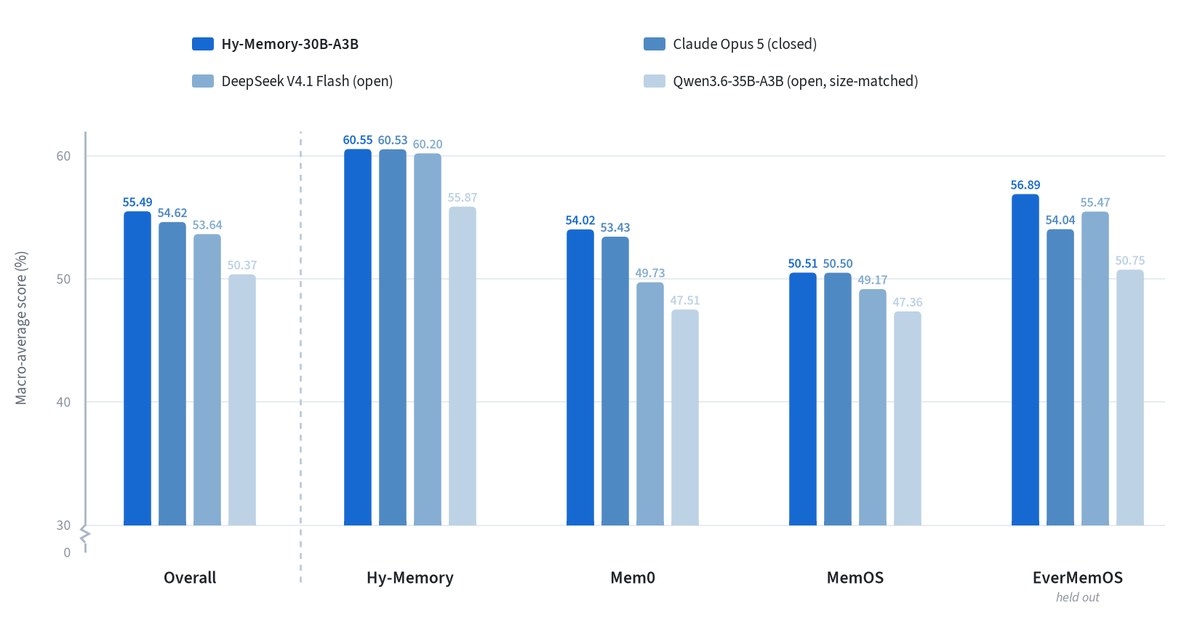
中国TencentのHunyuanチームは10月16日、AIエージェントの長期記憶を書き込む専用のモデル「Hy-Memory-30B-A3B」を公開した。あわせて、記憶を管理する仕組み「Hy-Memory 2.0」と、Claude Code、Cursor、Codexなど複数の開発ツールの間で1つの記憶を共有するアプリ「MemHub」も公開した。LICENSEファイルではどれもApache 2.0で追加の制限はなく、商用でも使える。6種類の試験で問題の20%だけを採点した平均点は55.49で、米AnthropicのClaude Opus 5の54.62を上回ったとしている(会社の申告)。
何を覚えるかを決める役だけをこなすモデル
エージェントの記憶の仕組みでは、会話や作業の記録から「何を残すか」「前の記憶をどう書き換えるか」を決める役に、ふつうは汎用の大きなモデルを使う。Hy-Memory-30B-A3Bは、この書き込みの役だけのために訓練したモデルだ。
全体の大きさは300億パラメーターだが、1回の処理で動かすのは約30億パラメーター分だけの作りだ。モデルの説明ページは、vLLMで動かし、OpenAI互換のAPIとして呼ぶ例を載せている。手元やクラウドの小さめのGPUで記憶の書き込みを回せれば、そのたびに大きなモデルのAPIに払う費用を抑えられる(編集部の推測)。
Hugging Faceのページでは、モデルの置き場所は10月15日に作られ、最終の更新は10月16日午後5時12分(日本時間)だ。Tencentの公式サイトは、公開日を10月16日としている。
Opus 5との差は1点に満たない
数字は細かく見たほうがいい。Hunyuanチームの技術報告によると、比べ方は、記憶の仕組み(Mem0、MemOS、Hy-Memory、EverMemOS)の中の書き込み役だけを差し替え、6種類の試験の平均を取るというものだ。結果は次のとおり(会社の申告)。
- Hy-Memory-30B-A3B:55.49
- Claude Opus 5:54.62
- DeepSeek V4.1 Flash:53.64
- 同じ大きさのQwen3-30B-A3B:44.37
Opus 5との差は0.87点だ。仕組みごとに見ると、MemOSでは50.51対50.50、Hy-Memoryでは60.55対60.53で、ほぼ並んでいる。差がはっきり出たのは、訓練に使わなかったEverMemOS(56.89対54.04)だった。試験の種類別では、会話の記憶を問うLoCoMoなどでOpus 5が上回る場面もある。しかも、どの試験も問題の20%だけを抜き出して採点している。
「Opus 5と同じくらいの書き込みを、ずっと小さいモデルでこなせる」と読むのが妥当で、「Opus 5より賢い」という話ではない。
MemHubは開発ツールの記録を集める
読者に近いのはMemHubだ。GitHubの説明によると、MemHubは利用者が許可した開発ツールの会話や作業の記録を、自分のパソコンの1か所に集める。例として挙げているのはClaude Code、Cursor、Codex、OpenCode、Qwen Codeで、公式サイトは10種類の開発ツールで記憶を共有できるとしている。集めた記憶は、道具ごとに許可を出して呼び出させる。Claude Codeで決めた設計の理由を、翌日にCodexで作業する時に思い出させる、といった使い方を想定している。
記憶の仕組みのほうは、作業の記憶(任務がどこまで進んだか、どの経験が使えるか)と、コードの記憶(なぜこう書き換えたか)を新たに加えた。Pythonの部品はhy-memory 2.0.3として配られている。
入れる前に確かめたいこと
MemHubの説明は、今の版を試験版と書いている。対応するのはLinuxとmacOSで、Windowsは対象外だ。データは既定でホームフォルダーの「.one-memory」に保存され、アンインストールしても記憶は消えない。記憶を消すにはmemhub delete-dataという別の命令が要る。サービスと本体を外すmemhub uninstallでは、記憶は残る。
記憶を整理するのに外部のモデルサービスを使うかどうかは、利用者が選ぶ作りだ。選んだ場合は、送り先と送る範囲、使い道を使い始める前に表示するという。既定でどこに送るかは、説明に書かれていない(未確認)。Tencentのクラウドに送るという記載も見当たらない。外部のサービスを選べば、許可した会話の中身はそこに送られる。プライバシーの説明によると、診断の設定を最も詳しい段階に切り替えると、モデルとのやり取りの全文が手元の記録ファイルに残る。仕事のリポジトリの記録を入れるなら、どの道具の記録を集めるか、外部のモデルに何を送るかを先に決めておきたい。
編集部の見方
Claude CodeやCodexを使い分けていると、前の会話で決めたことを毎回説明し直す手間がかかる。MemHubはそこを狙っており、手元に記憶を置く作りも筋がいい。ただ試験版で、書き込みモデルの「Opus 5超え」も1点に満たない差だ。すぐ仕事の記録を流し込むより、まず個人のリポジトリで試し、記憶が本当に役に立つか、外に何が送られるかを見てからにしたい。
出典
に確認(日本時間)
- Hugging Faceのページ(huggingface.co)
- Tencentの公式サイト(memory.hunyuan.tencent.com)
- Hunyuanチームの技術報告(arxiv.org)
- GitHubの説明(github.com)
この記事は役に立ちましたか
ありがとうございます
ありがとうございます